


使用Python爬取Bangumi动漫数据
529 字
3 分钟
使用Python爬取Bangumi动漫数据
前述: -基本流程:网页请求 → 链接解析 → 信息提取 → 保存数据
-Github项目链接:bgm_crawler
1.调用库
| 库 | 作用 |
|---|---|
urllib.request | 发送 HTTP 请求 |
BeautifulSoup | 解析 HTML |
re | 正则表达式,提取文本 |
xlwt | 写入 Excel |
time | 控制请求间隔 |
2.主要结构
代码主要分为四部分四个函数。
| 函数 | 作用 |
|---|---|
main() | 主流程:循环翻页、调用其他函数 |
ask_url(url) | 发请求,返回 HTML |
get_data(html) | 从 HTML 提取数据 |
save_data(data, filename) | 将数据写入 Excel |
2.1 main()
def main(start, end): start = int(input("请输入起始页: ")) end = int(input("请输入结束页: ")) file_name = (input("请输入保存文件名:"))+'.xls' base_url = 'https://bgm.tv/anime/browser?sort=rank&page=' #网站url前缀 datalist = []
for page in range(start-1, end): #页码范围 current_url = f"{base_url}{page + 1}" html = ask_url(current_url) #调用函数,获取HTML if html: datalist.extend(get_data(html)[1:-1]) #调用函数,获取数据 time.sleep(0.5) #爬取频率0.5
save_data(datalist, 'workover1.xls') #调用函数,数据保存为xls文件2.2 askurl(url)
def ask_url(url): #防反爬(网站无需登陆,不需要cookie) headers = { 'User-Agent': '<填入你的 User-Agent>' #在网站中获取User-Agent填入 } req = urllib.request.Request(url=url, headers=headers, method='GET') #打包请求信息
try: with urllib.request.urlopen(req) as response: #发送请求 return response.read().decode('utf-8') #获取网站返回,解码 except urllib.error.URLError as e: #请求失败返回None return None2.3 get_data(html)
def get_data(html): soup = BeautifulSoup(html, 'html.parser') #解析HTML results = []
for item in soup.find_all('div', class_="inner"): item_str = str(item) entry = [ re.findall(r'<a class="l" href="/subject/.*?">(.*?)</a>', item_str), # 名字 re.findall(r'</small> <span class="tip_j">\((.*?)\)</span>', item_str), # 评论数 re.findall(r'<small class="fade">(.*?)</small>', item_str) # 评分 ] #正则表达获取指定数据 results.append(entry)
return results2.4 save_data(data_list, filename)
def save_data(data_list, filename): book = xlwt.Workbook(encoding='utf-8') sheet = book.add_sheet('reviews', cell_overwrite_ok=True)
# 写入表头 headers = ('名字', '评论数', '评分') for col, header in enumerate(headers): sheet.write(0, col, header)
# 写入数据 for row, entry in enumerate(data_list, start=1): for col, value in enumerate(entry): sheet.write(row, col, value[0] if value else '') # 取列表第一个元素或空字符串
book.save(filename)3.使用和结果
3.1 直接调用运行 main() 获得结果
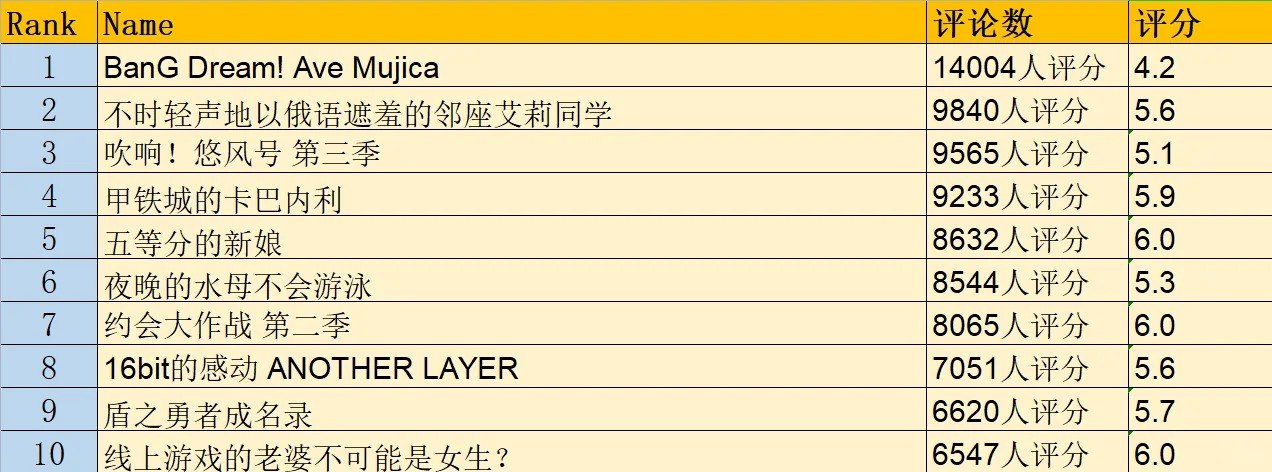
3.2 结果展示
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!